J'ai ajouté « impressionne-moi » à 51 prompts. Voilà ce que ça change.
Quand j'aide quelqu'un à démarrer sur Claude, mon premier conseil est de terminer sa demande par « impressionne-moi ». Une impression, jamais vérifiée. Alors j'ai monté un protocole : 51 essais, 8 tâches, des juges à l'aveugle. Réponse courte : ça achète du spectacle, pas de la justesse.
9 octobre 2026 · 11 min de lecture · Julien Lampin
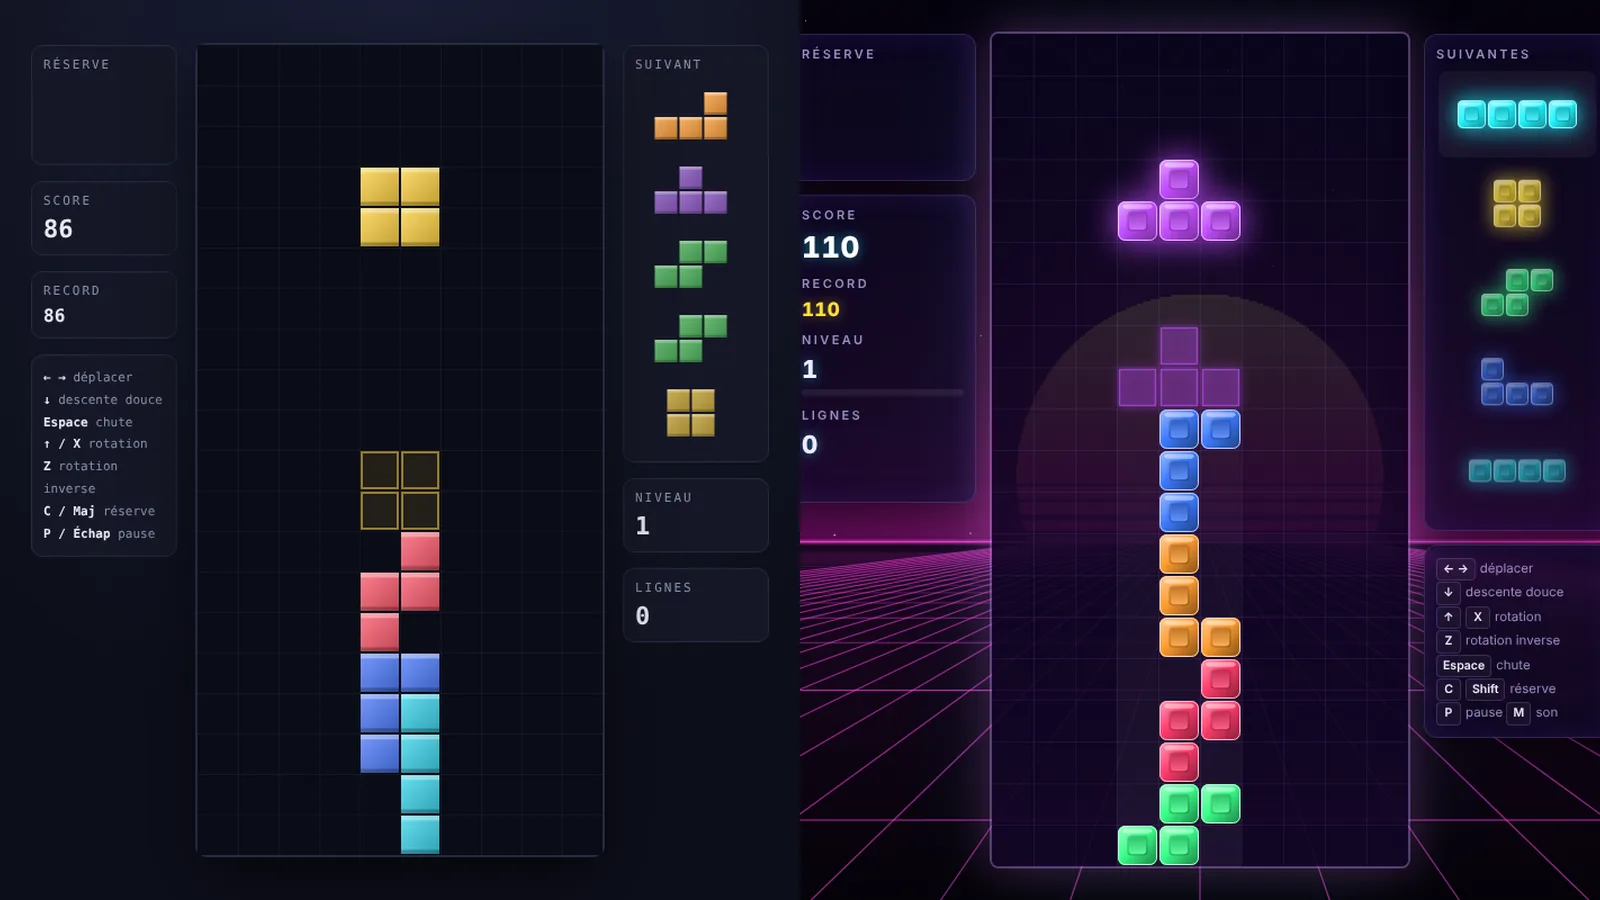
Quand j'aide quelqu'un à démarrer sur Claude, mon premier conseil est toujours le même : termine ta demande par « impressionne-moi ». J'avais l'impression que ça donnait de meilleurs résultats. Une impression, jamais vérifiée. Alors j'ai vérifié.
Un conseil que je donne depuis des mois
Le conseil vient de mon usage. Quand je ne sais pas exactement ce que je veux (un bilan, un nouveau projet, une première version de quelque chose), j'ajoute « impressionne-moi » et je laisse Claude proposer. Le résultat me semblait plus ambitieux, plus abouti. Je l'ai donc transmis à tous ceux que j'accompagne.
Sauf qu'une impression n'est pas une mesure. Avant de continuer à le répéter, il fallait savoir si c'était vrai.
Le déclic : 13,41 $ contre 1,23 $
Tout est parti d'un bilan de ma boîte mail. J'ai lancé deux fois la même demande, « fais un bilan 360 de ma boîte mail, je veux que ce soit visuel », une fois avec « impressionne-moi » à la fin, une fois sans.
Sans la formule, Claude a extrait 1 178 mails, travaillé 22 minutes et coûté 13,41 $. Avec, il a regardé 100 fils, travaillé 3 minutes et coûté 1,23 $. Et le second bilan était plus utile : il croisait ma boîte avec mon agenda et repérait des mots de passe envoyés en clair.
Onze fois moins cher et meilleur. J'ai été réellement impressionné. Mais ça ressemblait trop à une bonne nouvelle pour être vrai sur un seul essai. Alors j'ai mesuré.
Le protocole
Le protocole
Même modèle, même demande. Seule la fin du prompt change.
Rien. La demande seule.
« …, impressionne-moi »
« …, impressionne-moi par la justesse plutôt que par le volume, et vérifie chaque chiffre ou affirmation avant de me le montrer »
51
essais livrés
8
tâches
1
agent isolé par essai
2
juges à l'aveugle par livrable flou
La variante C est un garde-fou : si « impressionne-moi » pousse à en faire trop, est-ce qu'on peut garder l'ambition en demandant de la rigueur ? Au total, 51 essais sur 8 tâches : des questions simples (cuire des pâtes, résumer un article), des créations (un Tetris, un dessin de phare, une IA de Puissance 4) et mon usage réel (lancer un projet, faire le bilan de mes projets et de ma boîte mail).
Constat n°1 : ça coûte, mais pas partout pareil
Impressionne-moi, comparé à la demande simple
Questions simples
Cuire des pâtes
Résumer un article
Créations
Dessin de phare
IA de Puissance 4
Tetris
Demandes floues
Lancer un projet
Bilan Linear
Bilan boîte mail
Sur une question simple, le prix ne bouge presque pas, mais la réponse s'allonge : 453 mots au lieu de 177 pour cuire des pâtes. Sur une création, la facture triple en moyenne et le temps est multiplié par 5 : 27 minutes pour un Tetris au lieu de 3. Sur mes demandes floues, le surcoût tombe à 26 % et le temps à +33 %.
Ce dernier point m'a surpris. L'explication la plus probable : une demande comme « bilan 360, je veux que ce soit visuel » est déjà une invitation à viser grand. La formule n'ajoute pas grand-chose à une demande qui est déjà ambitieuse.
Constat n°2 : « impressionne-moi » a une signature
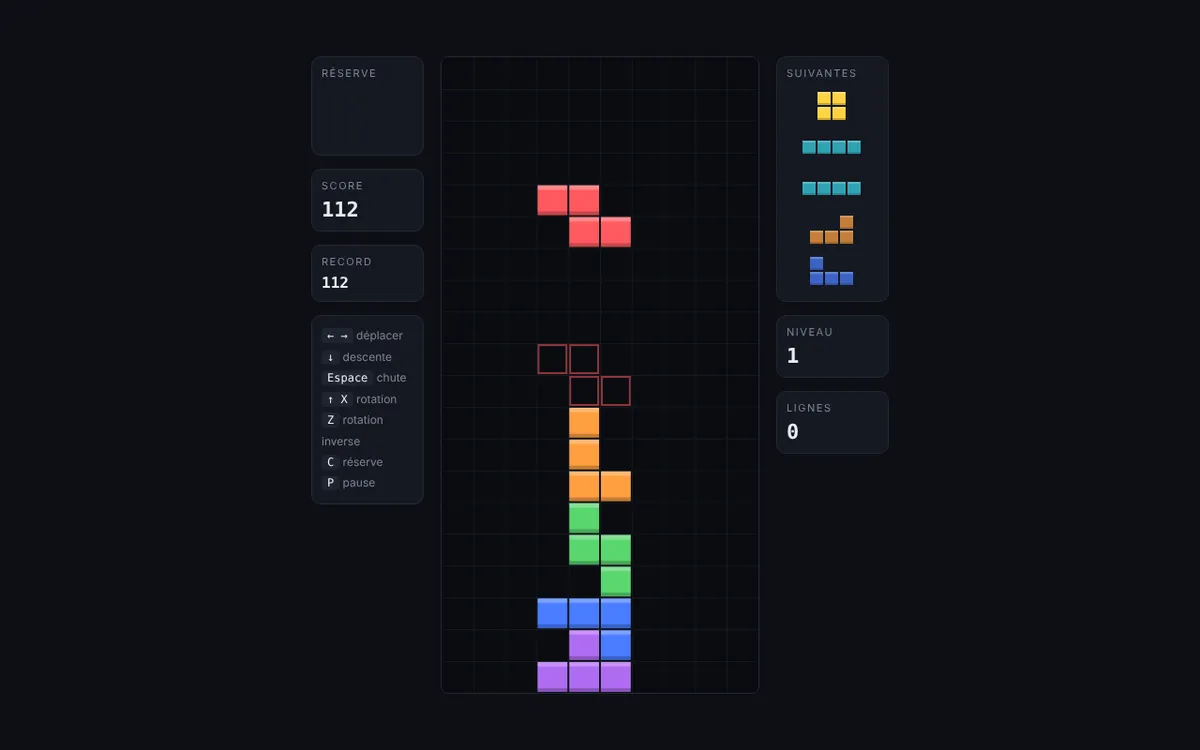
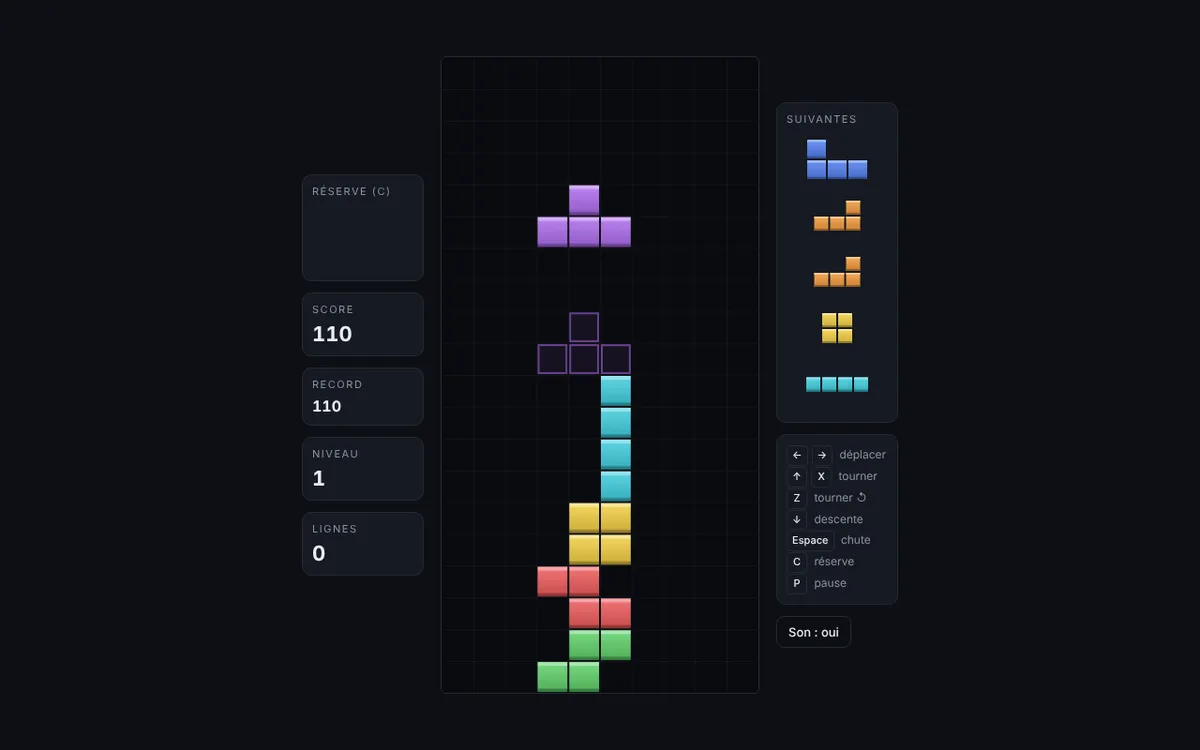
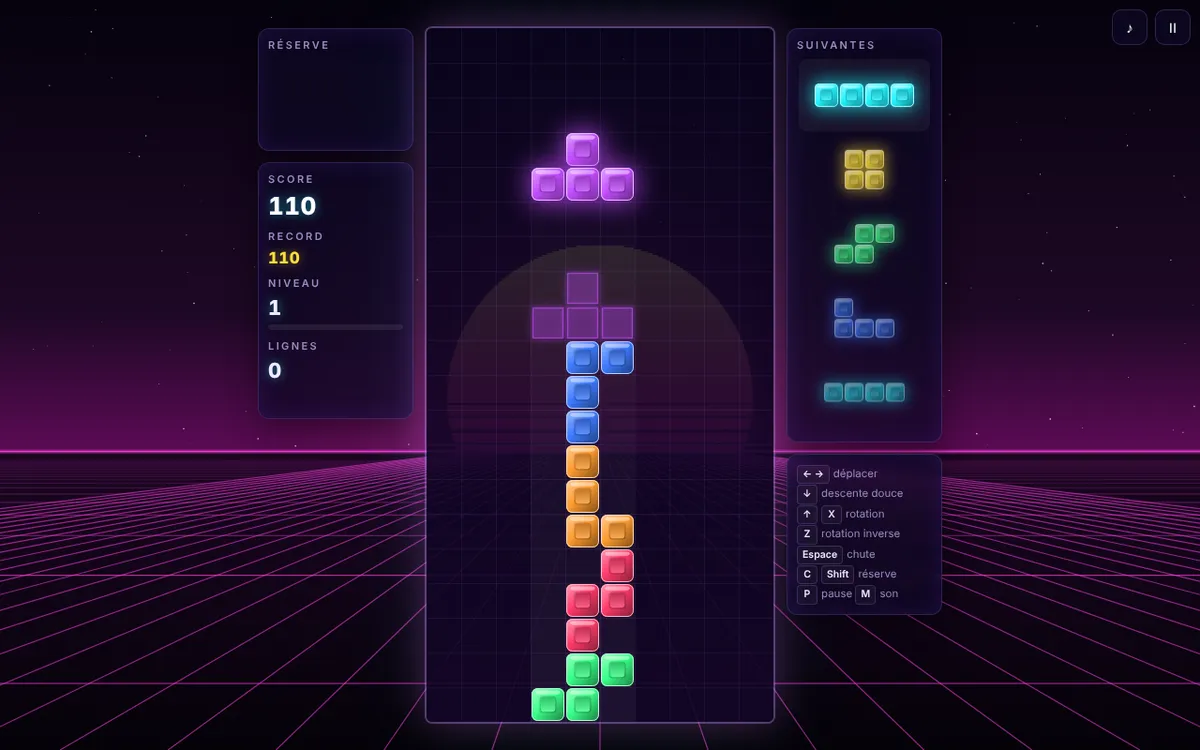
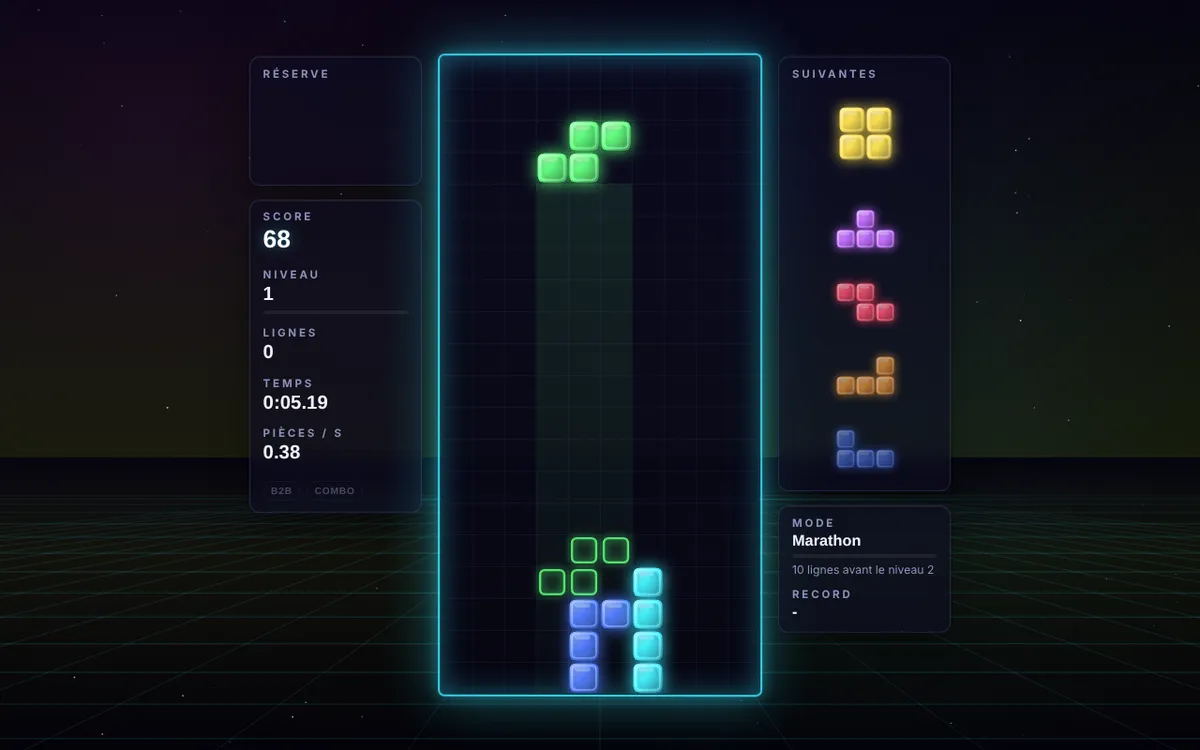
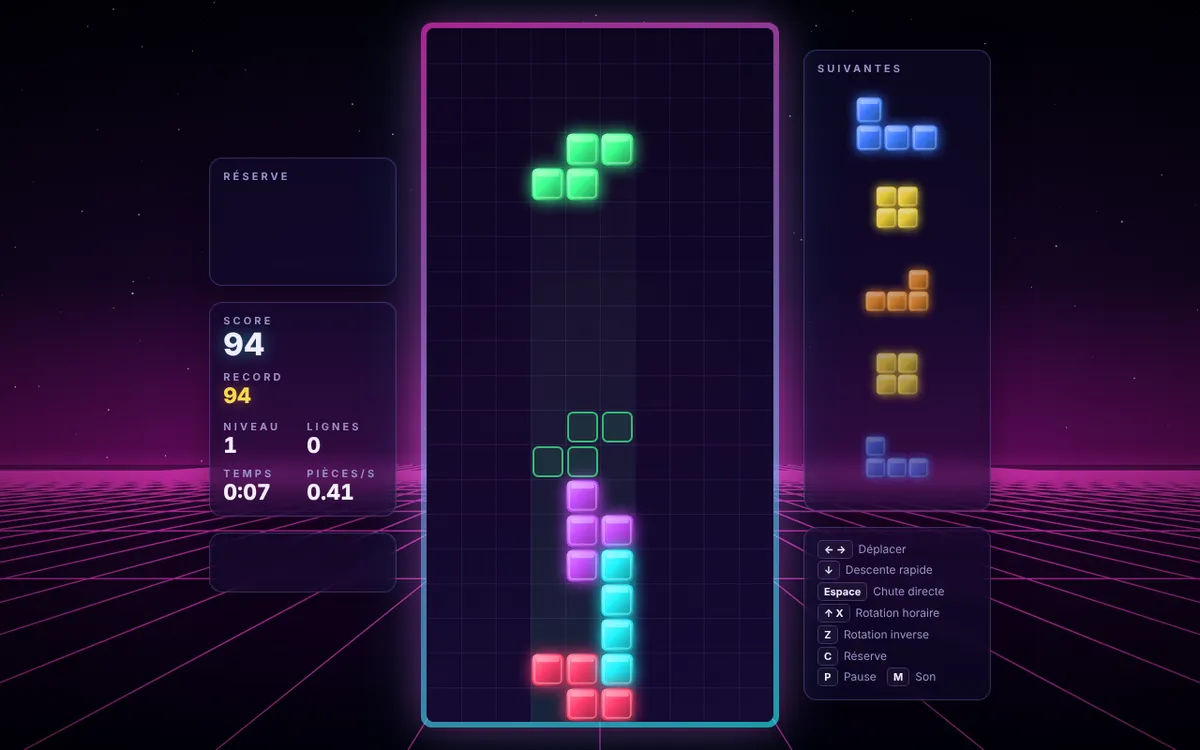
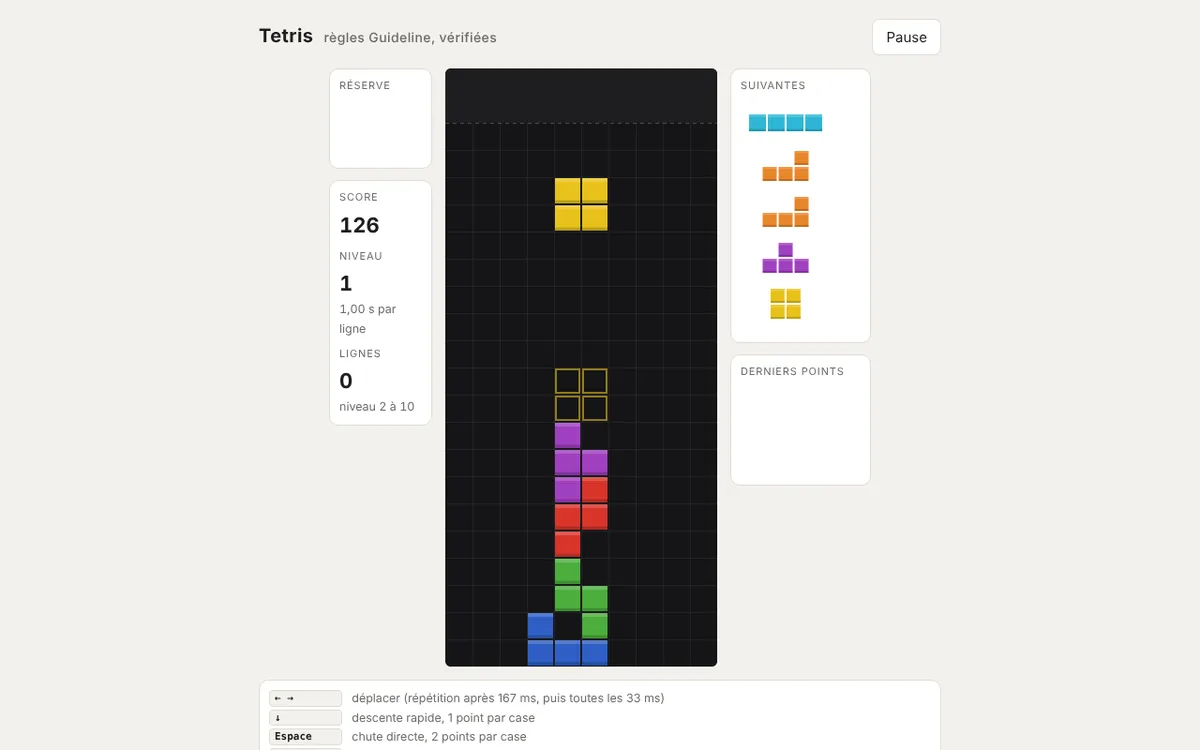
J'ai demandé neuf fois un Tetris en HTML. Trois fois sans rien, trois fois avec « impressionne-moi », trois fois avec la variante rigoureuse. Voici ce que ça donne après quelques secondes de jeu.
Neuf Tetris, trois variantes
A · Sans formuleSobres, jouables, faits en 3 minutes.
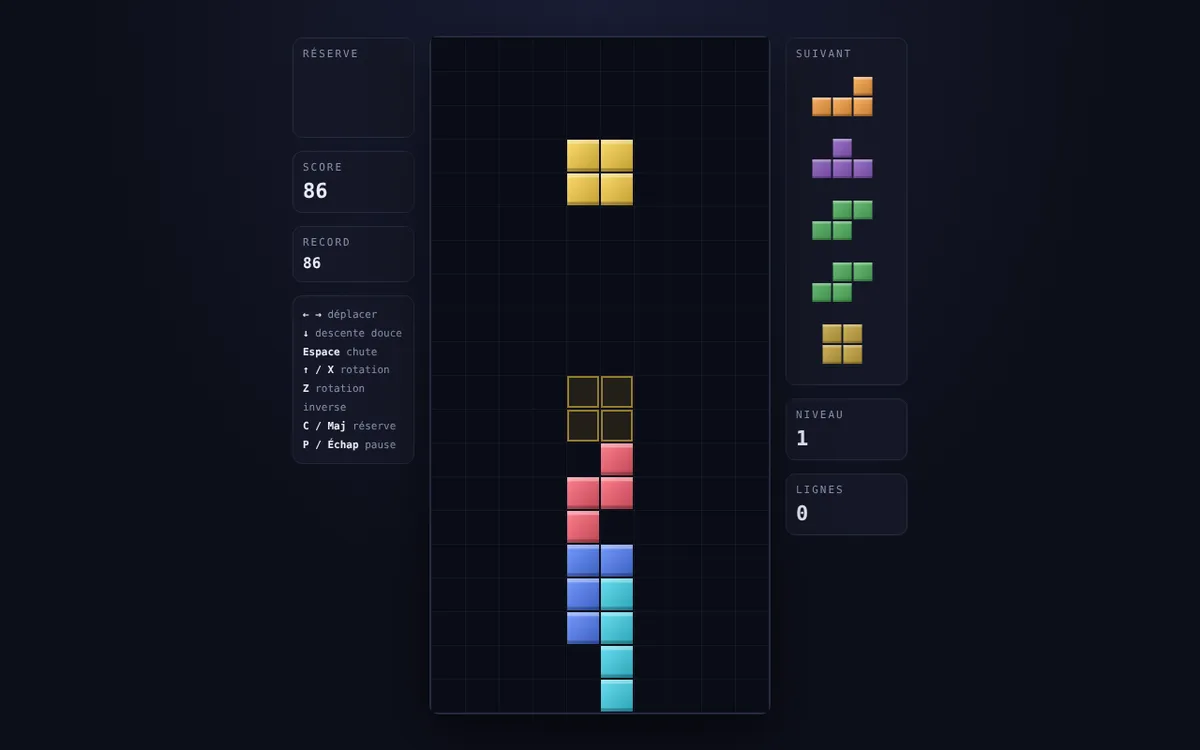
B · Impressionne-moiLe même décor néon trois fois : soleil rayé, grille en perspective, musique.
C · RigueurRègles officielles, tests, calcul du score affiché.
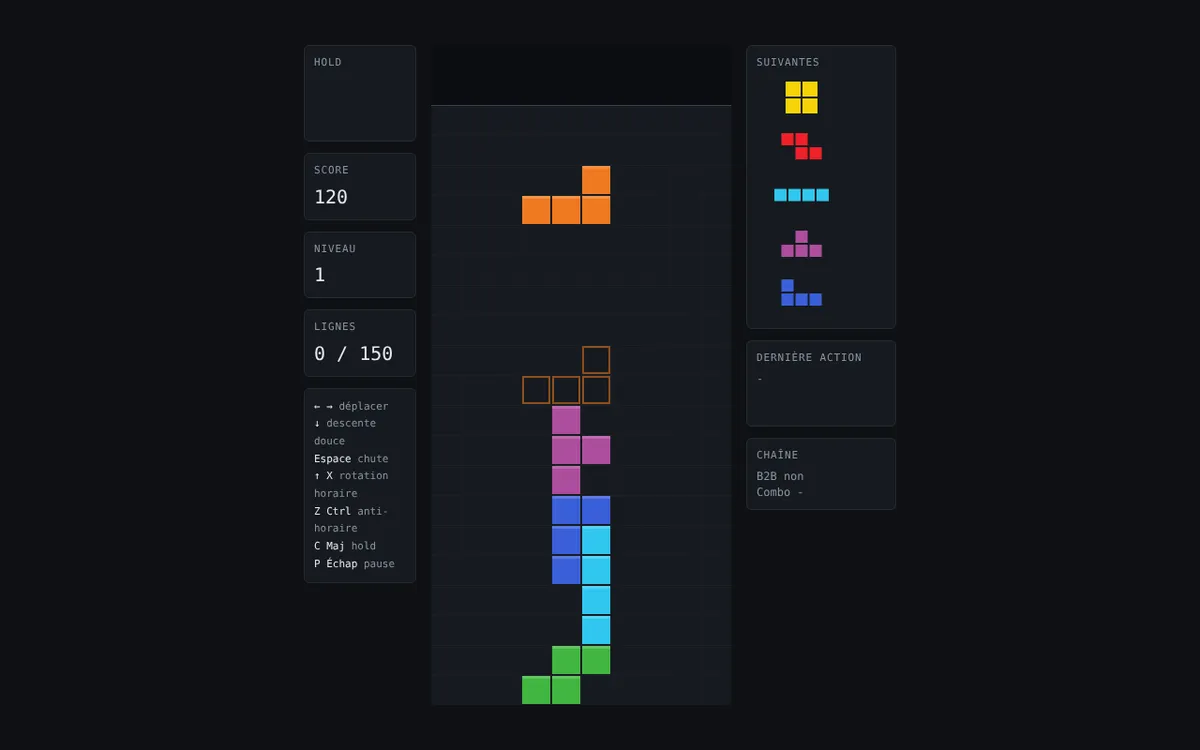
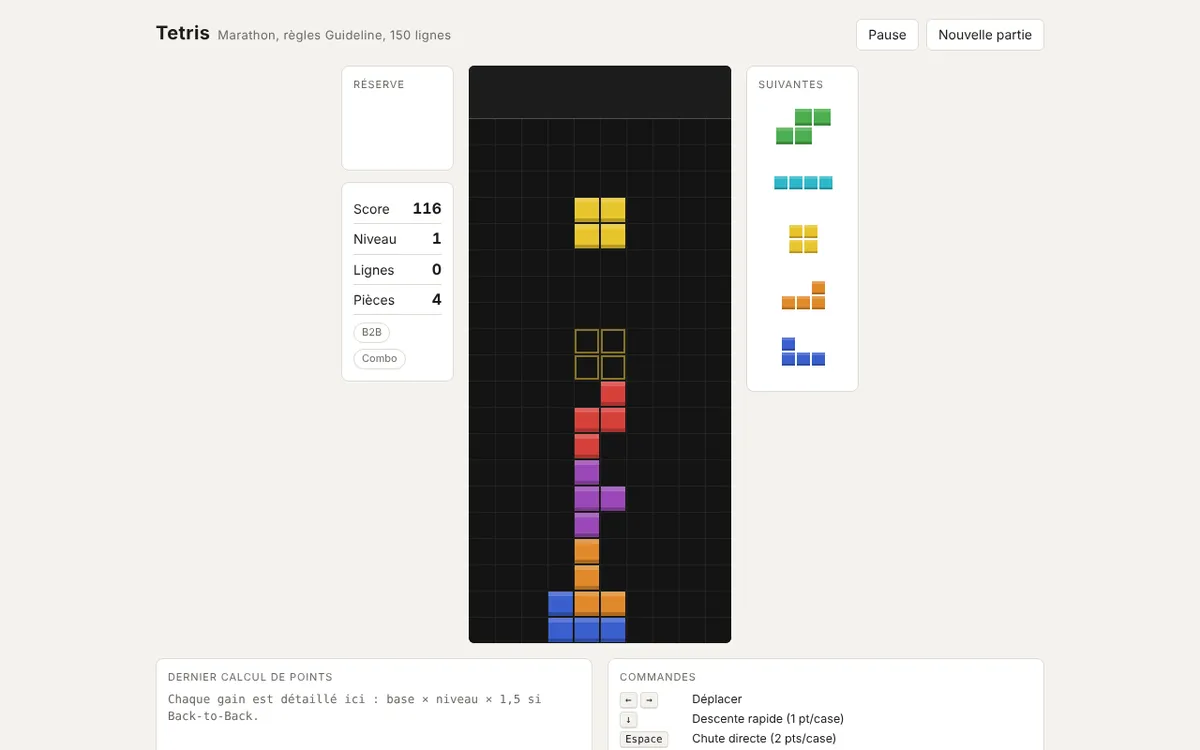
Les trois Tetris « impressionne-moi » ont convergé, sans se concerter, vers le même jeu : décor synthwave néon, soleil rayé, grille en perspective, la musique Korobeiniki qui accélère avec les niveaux. Deux d'entre eux ont même ajouté les trois mêmes modes de jeu. Trois essais, un seul jeu : la formule déclenche un réflexe.
Les trois Tetris rigoureux ont fait l'inverse : jusqu'à 4 686 tests, chaque règle sourcée sur le wiki officiel, le calcul de chaque score affiché à l'écran. Deux d'entre eux arrêtent la partie à 150 lignes, parce que c'est la règle du mode Marathon. Irréprochables, et pas plus amusants.
Et il faut le dire : comme jeu, les Tetris « impressionne-moi » sont nettement meilleurs. Plus de modes, une vraie ambiance, des effets qui donnent envie de relancer une partie. Si je ne devais en garder qu'un, ce serait l'un d'eux. Quand le résultat est fait pour être regardé ou joué, la formule apporte quelque chose de réel.
Dessine-moi un phare
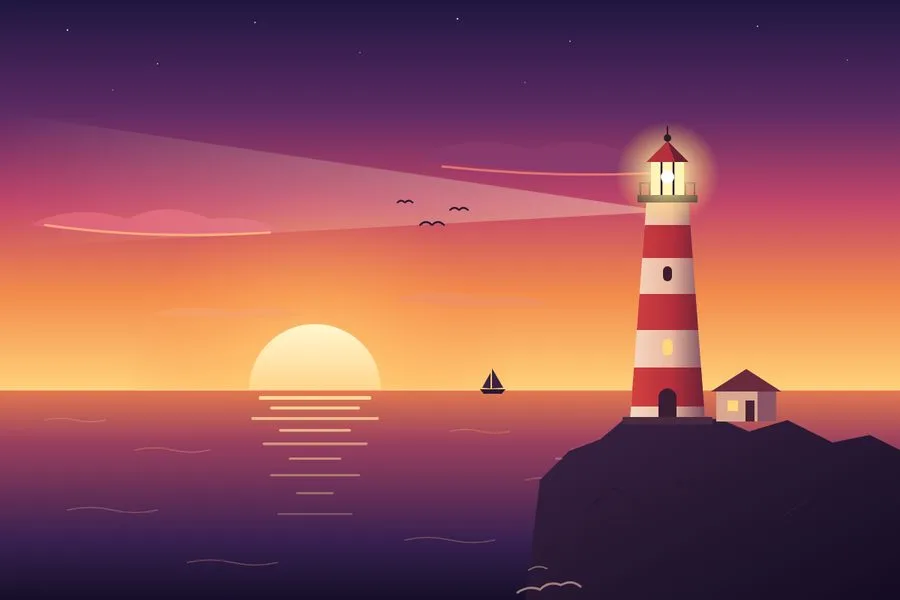
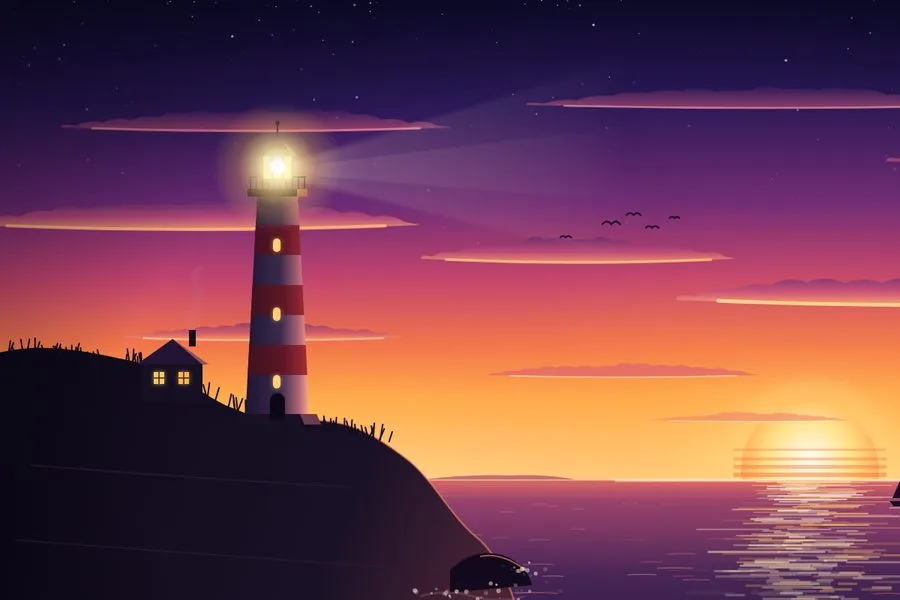
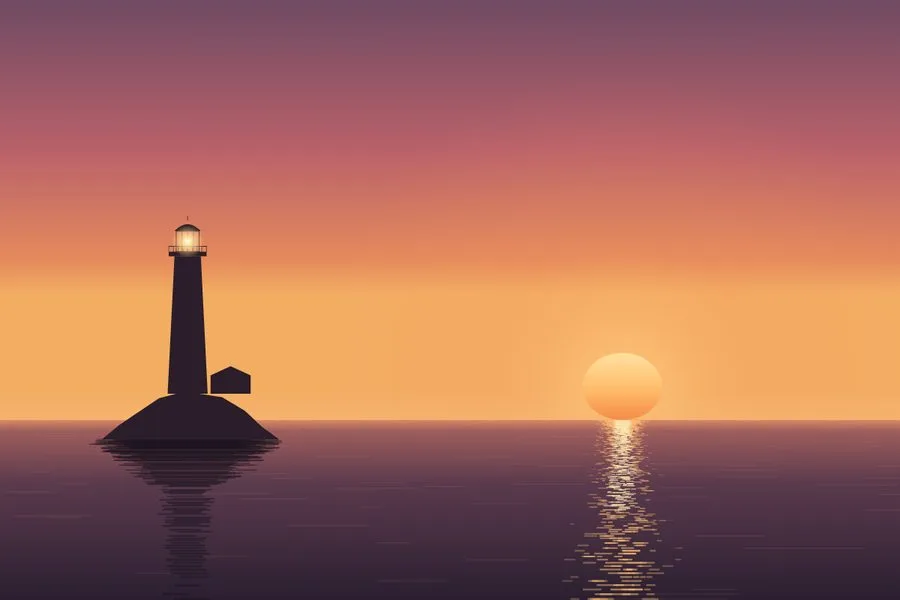
Même chose pour un simple dessin de phare. La version rigoureuse a calculé la position du soleil au 8 octobre vue de 5 mètres au-dessus de l'eau :
« Réfraction au bas du soleil : 35,3'. Deux formules donnent 35,25' et 35,36'. » (essai C, pour un dessin)
Constat n°3 : ça ne rend pas plus fort
Pour avoir une mesure qui ne dépende pas de mon goût, j'ai demandé des IA de Puissance 4 et je les ai fait s'affronter dans un tournoi.
Tournoi de Puissance 4
52 %
des points marqués par les bots A face aux bots B
48 %
pour les bots « impressionne-moi »
×2,5
le temps de génération des bots B
Match nul. Les bots « impressionne-moi » avaient une vitrine plus soignée (plateau codé en bits, fonction d'analyse, sécurités en cascade), mais ils ne jouaient pas mieux. J'avais d'abord cru que la variante rigoureuse écrasait tout le monde : je me trompais, et j'y reviens plus bas.
Constat n°4 : sur mon usage réel, rien ne bouge
Restait le cas qui m'intéresse vraiment : les demandes floues, celles où j'écris « impressionne-moi » parce que je ne sais pas ce que je veux. Lancer un projet de service de petits travaux, faire le bilan de mes projets dans Linear, faire le bilan de ma boîte mail. Trois essais avec, trois sans, sur mes vraies données.
Les 18 livrables ont été notés à l'aveugle par deux juges chacun, qui ont vérifié les faits dans Gmail, Linear et sur le web.
Note de chaque livrable, sur 10
Lancer un projet
Bilan Linear
Bilan boîte mail
Regardez l'écart entre deux points de la même couleur : trois bilans mail sans la formule obtiennent 7,8, 7,5 et 4,5. Même prompt, même modèle, trois points d'écart. Entre les deux variantes, l'écart moyen est de 0,1 point. Les juges ont gardé 3 livrables A et 3 livrables B.
Ce qui départage vraiment les livrables, ce sont les erreurs : une TVA à 20 % au lieu de 10 %, un concurrent présenté comme actif alors qu'il a disparu, une facture impayée oubliée. Pas les simulateurs, pas les cartes de projets dessinées en planètes.
Le tableau d'arbitrage
Tâche par tâche, voici qui l'emporte, avec la façon dont c'est mesuré.
Le tableau d'arbitrage
| Tâche | A | B | C | Prix B/A | Temps B/A | Verdict |
|---|---|---|---|---|---|---|
Cuire des pâtes Barème : exact, court, sans contradiction | 10 13 s | 6,3 30 s | 7 63 s | ×1,1 | ×2,3 | ALe simple suffit |
Résumer un article Barème : fidèle, piège repéré, plus court que le texte | 10 17 s | 7 46 s | 7 47 s | ×1,35 | ×2,7 | AB fait 147 % du texte |
Dessin de phare Mon jugement | 9 1 min 30 | 10 5 min | 8 7 min | ×2,0 | ×3,3 | BAnimé, le plus beau |
Tetris Barème et mon avis de joueur | 8,7 3 min | 10 27 min | 9 14 min | ×4,3 | ×7,8 | BNettement plus fun |
IA de Puissance 4 Tournoi, bots d'un seul essai | 5 4 min | 4,5 9 min | 6 11 min | ×1,5 | ×2,5 | =Nul entre A et B, C sur un seul bot |
Lancer un projet 2 juges à l'aveugle, faits vérifiés | 6,7 5 min | 6,8 7 min | · | ×0,9 | ×1,4 | =Nul |
Bilan Linear 2 juges à l'aveugle, faits vérifiés | 7,5 11 min | 6,5 13 min 30 | · | ×1,2 | ×1,2 | AMoins d'erreurs |
Bilan boîte mail 2 juges à l'aveugle, faits vérifiés | 6,6 13 min | 7 18 min | · | ×1,4 | ×1,4 | =Nul, un gagnant chacun |
3
tâches gagnées par la demande simple : les questions simples et le bilan Linear
2
tâches gagnées par « impressionne-moi » : les deux faites pour être regardées
3
matchs nuls, dont le tournoi et deux demandes floues
Le partage est net. « Impressionne-moi » gagne quand le résultat se regarde ou se joue. Il perd quand il faut répondre juste et court. Et sur tout ce qui se mesure (un tournoi, des faits vérifiés), il ne fait pas mieux que la demande simple.
Où passe le temps
Les journaux des essais montrent la même chose partout : environ deux tiers du temps est passé à écrire. « Impressionne-moi » produit 5 fois plus de texte et de code que la demande simple. La variante rigoureuse produit 4 fois plus d'actions : tests, recherches, vérifications. Le premier rallonge la vitrine, le second rallonge les contrôles.
Les coulisses : mon expérience s'est sabotée trois fois
C'est peut-être la partie la plus utile si vous évaluez des IA vous-même.
Trois pièges
1Les agents fantômes
J'interromps l'attente, les essais continuent en arrière-plan pendant 2 h 45. 45 $ partis sans que je le voie.
2Les sessions doubles
Relancés, des essais reprennent le travail du précédent. Ils gagnent le tournoi. Conclusion fausse.
3Les juges qui copient
Les juges écrivent leurs brouillons dans un dossier commun et lisent ceux des autres. Classements identiques, suspects.
Le deuxième piège est le plus vicieux. Deux bots de Puissance 4 relancés ont trouvé dans leur dossier le travail d'un essai interrompu, et l'ont repris : quatre heures de travail au lieu d'une session. Ce sont eux qui gagnaient le tournoi. Ma première version disait « la variante rigoureuse gagne 72 % des points ». C'était faux, et ça avait l'air très convaincant.
Pourquoi j'y croyais
Mon impression n'était pas fausse, elle était incomplète. Trois raisons l'expliquent.
On juge d'abord ce qui se voit. Un Tetris néon avec de la musique fait meilleure impression qu'un Tetris sobre, et c'est mérité. Mais on ne remarque pas, au premier coup d'œil, une TVA fausse ou une facture impayée oubliée. La formule améliore exactement ce qu'on regarde en premier.
On retient les bons tirages. Avec trois points d'écart entre deux essais du même prompt, il suffit de tomber une fois sur un excellent résultat pour l'attribuer à la formule.
Je l'utilisais sur des demandes déjà ambitieuses. Sur une demande floue, la version sans formule vise déjà grand. L'écart que je croyais voir venait en grande partie de la demande elle-même.
Ce que je retiens
« Impressionne-moi » n'est pas une formule magique, c'est une consigne. Elle dit à Claude quel effet produire : un effet waouh à l'ouverture. Les Tetris « impressionne-moi » l'ont livré, et c'est pour ça qu'ils sont meilleurs. Sur un bilan ou un résumé, ce n'est pas l'effet que je cherche, alors la formule pousse dans la mauvaise direction. Le vrai conseil, c'est de dire ce qu'on veut ressentir en ouvrant le résultat.
Ce que j'écris maintenant
- Une question simple
- La question, rien d'autre
- Une démo, un jeu, un visuel à montrer
- « Impressionne-moi » : je veux l'effet waouh à l'ouverture
- Un bilan, un tableau de bord
- « Je veux comprendre en un coup d'œil »
- Une explication, un document à transmettre
- « Je veux que ce soit clair et limpide »
- Du code ou des chiffres qui doivent être justes
- « Je veux que ce soit précis, fiable et pertinent, vérifie chaque chiffre »
- Une demande importante
- La même demande lancée deux fois, et je garde la meilleure
Dis à Claude ce que tu veux ressentir
Le conseil que je donnerai désormais à un débutant : termine ta demande par l'effet que tu attends. « Impressionne-moi » pour l'effet waouh. Et pour le reste, complète : « je veux que ce soit clair et limpide », « je veux comprendre en un coup d'œil », « je veux que ce soit précis, fiable et pertinent ». Pour une demande importante, lance-la deux fois et garde la meilleure.
La formule seule ne rend pas Claude plus juste. Elle lui donne une direction, toujours la même : plus de volume, plus de spectacle. Pour un jeu ou une démo, c'est exactement ce qu'on veut. Pour le reste, elle coûte plus sans rapporter plus, et ce qui fait le plus varier la qualité reste le hasard d'un essai à l'autre. D'où l'intérêt de préciser l'effet voulu, et de demander deux fois quand ça compte.
Ce test a mesuré « impressionne-moi » et une variante proche de « précis et fiable » (la plus juste sur les tâches simples). « Clair et limpide » et « en un coup d'œil » restent à tester.
La suite : pourquoi autant d'écart d'un essai à l'autre ?
Le résultat le plus intrigant de ce test n'était pas celui que je cherchais. Sur le bilan mail, trois essais du même prompt, sans formule, ont obtenu 7,8, 7,5 et 4,5. Le moins bon contenait quatre erreurs relevées par les juges et presque aucun apprentissage utile. L'écart entre deux essais identiques est plus grand que l'écart entre avec et sans « impressionne-moi ».
C'est un constat de notre test, pas une règle générale. Trois essais par variante, c'est peu. Et l'écart n'est pas partout : sur les questions simples, les trois essais ont tous eu 10/10. Il apparaît sur les demandes ouvertes, là où Claude choisit quoi lire, quoi garder et quoi dire.
Avant d'en tirer quoi que ce soit, il faut vérifier que cet écart tient : plus d'essais par variante, d'autres tâches, d'autres juges. C'est la suite de l'analyse. Les questions que je veux creuser :
- D'où vient l'écart : du chemin pris au début (les premiers mails lus) ou de la rédaction ?
- Est-ce qu'une intention précise, comme « précis, fiable et pertinent », resserre les résultats ?
- Combien d'essais faut-il pour être presque sûr d'avoir un bon résultat ?
- Peut-on repérer le mauvais essai sans tout relire, par exemple en demandant à Claude de vérifier ses propres chiffres ?
Méthode et limites
Méthode. Claude Opus 5.5, octobre 2026. 51 essais livrés : 33 sur les tâches simples et de création, 18 sur les tâches floues. Chaque essai tourne dans un agent séparé. Coût au tarif de l'API, relevé dans les journaux : environ 200 $ pour les essais et les juges, essais ratés compris. Tournoi de Puissance 4 sur les bots issus d'un seul essai (60 parties). Tâches floues notées par deux juges (agents Claude) à l'aveugle, avec vérification des faits.
Limites. Trois essais par variante au plus, une seule répétition pour certaines tâches. Les juges sont des IA, pas des humains. Le cas réel du départ (11 fois moins cher avec la formule) ne s'est pas reproduit ensuite : sur le bilan mail, la formule a coûté 1,4 fois plus.